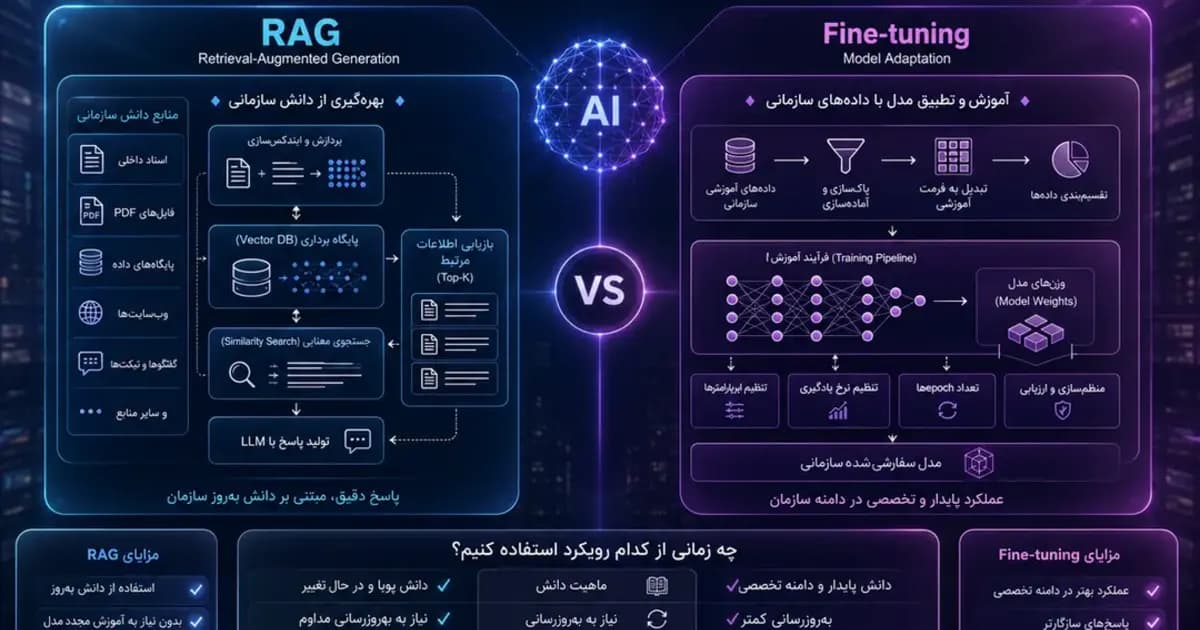
اگر هدف این است که مدل آییننامه جدید شرکت را بداند، Fine-tuning معمولاً اولین پاسخ نیست. اگر هدف این است که مدل همیشه خروجی را با Style و Format مشخص تولید کند، Vector Database بهتنهایی مشکل را حل نمیکند. RAG و Fine-tuning رقیب مستقیم نیستند؛ یکی عمدتاً دانش زمان اجرا را تأمین میکند و دیگری رفتار مدل را تغییر میدهد.
پاسخ کوتاه
RAG برای اتصال مدل به دانش خصوصی، متغیر و قابل استناد مناسب است. Fine-tuning برای آموزش الگوی پاسخ، Style، Format یا رفتار تخصصی روی نمونههای باکیفیت مفید است. اگر هم دانش متغیر و هم رفتار خاص لازم است، معماری Hybrid میتواند هر دو را استفاده کند؛ البته بعد از ساخت Evaluation baseline.
مقایسه RAG و Fine-tuning
| معیار | RAG | Fine-tuning |
|---|---|---|
| مسئله اصلی | دسترسی به دانش در زمان پاسخ | تغییر الگوی رفتار مدل |
| Update دانش | Re-index اسناد | Dataset/Training جدید ممکن است لازم شود |
| Citation | قابل طراحی با Source | بهصورت ذاتی منبع ارائه نمیکند |
| داده متغیر | مناسبتر | معمولاً نامناسب برای Facts متغیر |
| Latency | Retrieval/Rerank اضافه میکند | ممکن است Prompt کوتاهتر شود |
| عملیات | Ingestion، Index، ACL و Retrieval | Dataset، Training، Version و Model eval |
| حذف یک سند | قابل مدیریت در Index/Storage | حذف اثر داده Training ساده نیست |
| خطای رایج | Retrieval بد یا Context نامرتبط | Overfit، Dataset ضعیف یا رفتار ناخواسته |
RAG چگونه کار میکند؟
اسناد Ingest، پاکسازی و به Chunkهای مناسب تقسیم میشوند. برای هر Chunk Embedding و Metadata ساخته و در Index ذخیره میشود. هنگام سؤال، Query بازنویسی/Embed، Candidateها بازیابی، Filter دسترسی اعمال و در صورت نیاز Rerank میشوند. سپس Context محدود همراه Instruction به مدل میرود.
کیفیت RAG از این نقاط میآید:
- Chunking متناسب با ساختار سند، نه طول ثابت کور.
- Metadata برای Product، Version، Language، Department و ACL.
- Hybrid search یا Reranking برای Queryهای دشوار.
- Source attribution و نمایش Context قابل بررسی.
- Evaluation جداگانه Retrieval و Generation.
- Update و حذف سند با Provenance روشن.
Vector Database فقط یکی از اجزاست. اگر سند قدیمی، ACL غلط یا Query مبهم باشد، Retrieval سریع پاسخ غلط را سریعتر میکند.
Fine-tuning چه چیزی را تغییر میدهد؟
در Supervised Fine-tuning، نمونههای Input/Output به مدل نشان میدهند برای Task مشخص چگونه پاسخ دهد. Use Caseها میتوانند شامل Format ثابت، طبقهبندی تخصصی، لحن یا رفتار تکرارشونده باشند. اما Training Dataset باید نماینده Production، تمیز و با دستورهای سازگار باشد.
Fine-tuning Database دانش نیست. مدل ممکن است Fact را ناقص حفظ کند، Source ارائه ندهد و با Update آییننامه قدیمی شود. برای دادهای که باید دقیق، قابل حذف و قابل استناد باشد، Retrieval معمولاً کنترلپذیرتر است.
Decision Tree عملی
دانش شرکت مرتب تغییر میکند؟
RAG را اول ارزیابی کنید. مثال: قیمت، Policy، Product catalog، Ticket و اسناد حقوقی داخلی.
خروجی باید Format/Style ثابت داشته باشد؟
ابتدا Prompt و Structured Output. اگر کیفیت یا Cost/Latency کافی نیست و نمونه خوب دارید، Fine-tuning را آزمایش کنید.
پاسخ باید Source نشان دهد؟
RAG مناسبتر است؛ Citation باید از Mapping واقعی Chunk به سند تولید شود، نه اینکه مدل Source بسازد.
Task بدون سند خارجی و بسیار تکراری است؟
Fine-tuning میتواند مفید باشد، مشروط به Evaluation و حجم نمونه مناسب.
هر دو نیاز وجود دارد؟
Hybrid: مدل Fine-tuned رفتار/Format را رعایت میکند و RAG دانش تازه را میدهد. این معماری Complexity دو سیستم را همزمان دارد؛ فقط با منفعت اندازهگیریشده توجیه میشود.
هزینه واقعی
هزینه RAG
Ingestion، Parser، Embedding، Storage، Retrieval، Reranking، Token context، ACL، Monitoring و Re-index. هزینه بزرگ اغلب پاکسازی و Governance داده است.
هزینه Fine-tuning
تولید/بازبینی Dataset، Training، Version model، Evaluation، Hosting/usage و Retraining. Dataset ارزان اما ناسازگار بدهی رفتاری ایجاد میکند.
بهجای مقایسه فقط قیمت API، Cost per successful task و هزینه Failure را بسنجید.
Security و Privacy
در RAG، ACL باید قبل از قرارگرفتن Chunk در Context enforce شود. Filter براساس متن Prompt کافی نیست. Tenant، Department و Document permission در Retrieval layer کنترل شوند. Logها نیز ممکن است Context حساس داشته باشند.
در Fine-tuning، Data policy Provider، Retention، منطقه داده و امکان حذف باید بررسی شود. PII و Secret نباید بدون ضرورت وارد Dataset شوند. Dataset و Model artifact نیز دارایی حساساند.
Evaluation؛ بدون آن انتخاب معماری حدس است
Datasetی از سؤالهای واقعی، Edge case و پاسخ/Source مورد انتظار بسازید. برای RAG حداقل این لایهها را جدا بسنجید:
- Retrieval recall/precision یا relevance.
- Groundedness پاسخ نسبت به Context.
- Correctness و Citation accuracy.
- Refusal وقتی Source کافی نیست.
- ACL leakage test.
برای Fine-tuning، Base model + Prompt را Baseline بگیرید و Format adherence، Task accuracy، Regression عمومی و Safety را مقایسه کنید. اگر Improvement قابل توجه نیست، Complexity اضافه توجیه ندارد.
اشتباههای رایج
- Fine-tuning برای «آپلود PDFها».
- RAG بدون Metadata و ACL.
- سنجش فقط با Demoهای آسان.
- Context بسیار بزرگ برای پوشاندن Retrieval ضعیف.
- ترکیب همزمان RAG، Agent و Fine-tuning بدون Baseline.
- نداشتن Golden dataset و Versioning.
- اعتماد به Citation تولیدشده توسط مدل بدون Mapping واقعی.
معماری پیشنهادی مرحلهای
- Task و معیار موفقیت را تعریف کنید.
- Base model + Prompt/Structured Output را Baseline بگیرید.
- اگر دانش خصوصی لازم است، RAG ساده با Source بسازید.
- Retrieval و Generation را جدا Evaluate کنید.
- Reranking/Hybrid/Query rewrite را فقط برای Failure مشخص اضافه کنید.
- Fine-tuning را وقتی Behavior bottleneck است آزمایش کنید.
- Version، Rollback، Monitoring و Human escalation را پیش از Production تکمیل کنید.
جمعبندی
RAG برای «مدل چه چیزی بداند؟» و Fine-tuning برای «مدل چگونه رفتار کند؟» پاسخهای متفاوتی میدهند. در بسیاری از پروژهها Prompt + RAG نقطه شروع کنترلپذیر است و Fine-tuning پس از شناسایی bottleneck رفتاری معنا پیدا میکند. معماری درست با Evaluation تعیین میشود، نه نام ابزار.
مسیر مطالعه مرتبط
سؤالات متداول
RAG بهتر است یا Fine-tuning؟
هیچکدام مطلقاً بهتر نیست. RAG برای دانش متغیر و قابل استناد؛ Fine-tuning برای رفتار و Format تخصصی.
آیا Fine-tuning اطلاعات شرکت را به مدل یاد میدهد؟
ممکن است الگوهایی را جذب کند، اما برای Facts دقیق، Update و Citation ابزار مناسبی نیست. RAG معمولاً کنترل بیشتری میدهد.
آیا RAG به Vector Database نیاز دارد؟
به Retrieval نیاز دارد؛ Vector search رایج است اما Keyword/Hybrid و حتی Search موجود میتواند مناسب باشد. انتخاب براساس داده و Query است.
میتوان RAG و Fine-tuning را ترکیب کرد؟
بله، وقتی هم دانش تازه و هم رفتار خاص لازم است. Complexity و Cost باید با Evaluation توجیه شود.
چرا RAG پاسخ غلط میدهد؟
سند غلط/قدیمی، Chunking، Query، Retrieval، ACL، Context یا Generation میتواند عامل باشد. Pipeline را مرحلهای Debug کنید.
منابع رسمی و مطالعه بیشتر
قبل از انتخاب RAG یا Fine-tuning یک Baseline قابل اندازهگیری بسازید
اگر میخواهید AI به اسناد خصوصی شرکت پاسخ دهد یا رفتار تخصصی ثابتی داشته باشد، انتخاب RAG/Fine tuning باید از Dataset ارزیابی و Risk داده شروع شود. VOIDRA میتواند Baseline، Retrieval pipeline و آزمایش معماری را قبل از سرمایهگذاری کامل طراحی کند.
شروع مشاوره پروژه